Questo sito per persone e agenti
Pagine statiche con Astro, contenuti in Git, pubblicazione su Cloudflare Pages: le scelte del sito che pubblichiamo da ottobre 2026 e i controlli che le tengono in piedi.
Che cosa è cambiato rispetto al sito di prima?
Il sito precedente è raccontato in Il nostro sito web: Nuxt e Vue.js per l'interfaccia, Prismic per i contenuti. Quello che stai leggendo è stato riscritto da capo e pubblicato a ottobre 2026, con un vincolo che ha deciso molte delle scelte successive: i 120 indirizzi del vecchio sito dovevano restare identici. L'unica eccezione dichiarata è la pagina delle domande frequenti, spostata con un redirect permanente.
A ogni build un controllo confronta la sitemap con l'elenco di quegli indirizzi e verifica che ognuno corrisponda a un file davvero prodotto. Se ne manca uno, la pubblicazione si ferma.
Perché un sito statico?
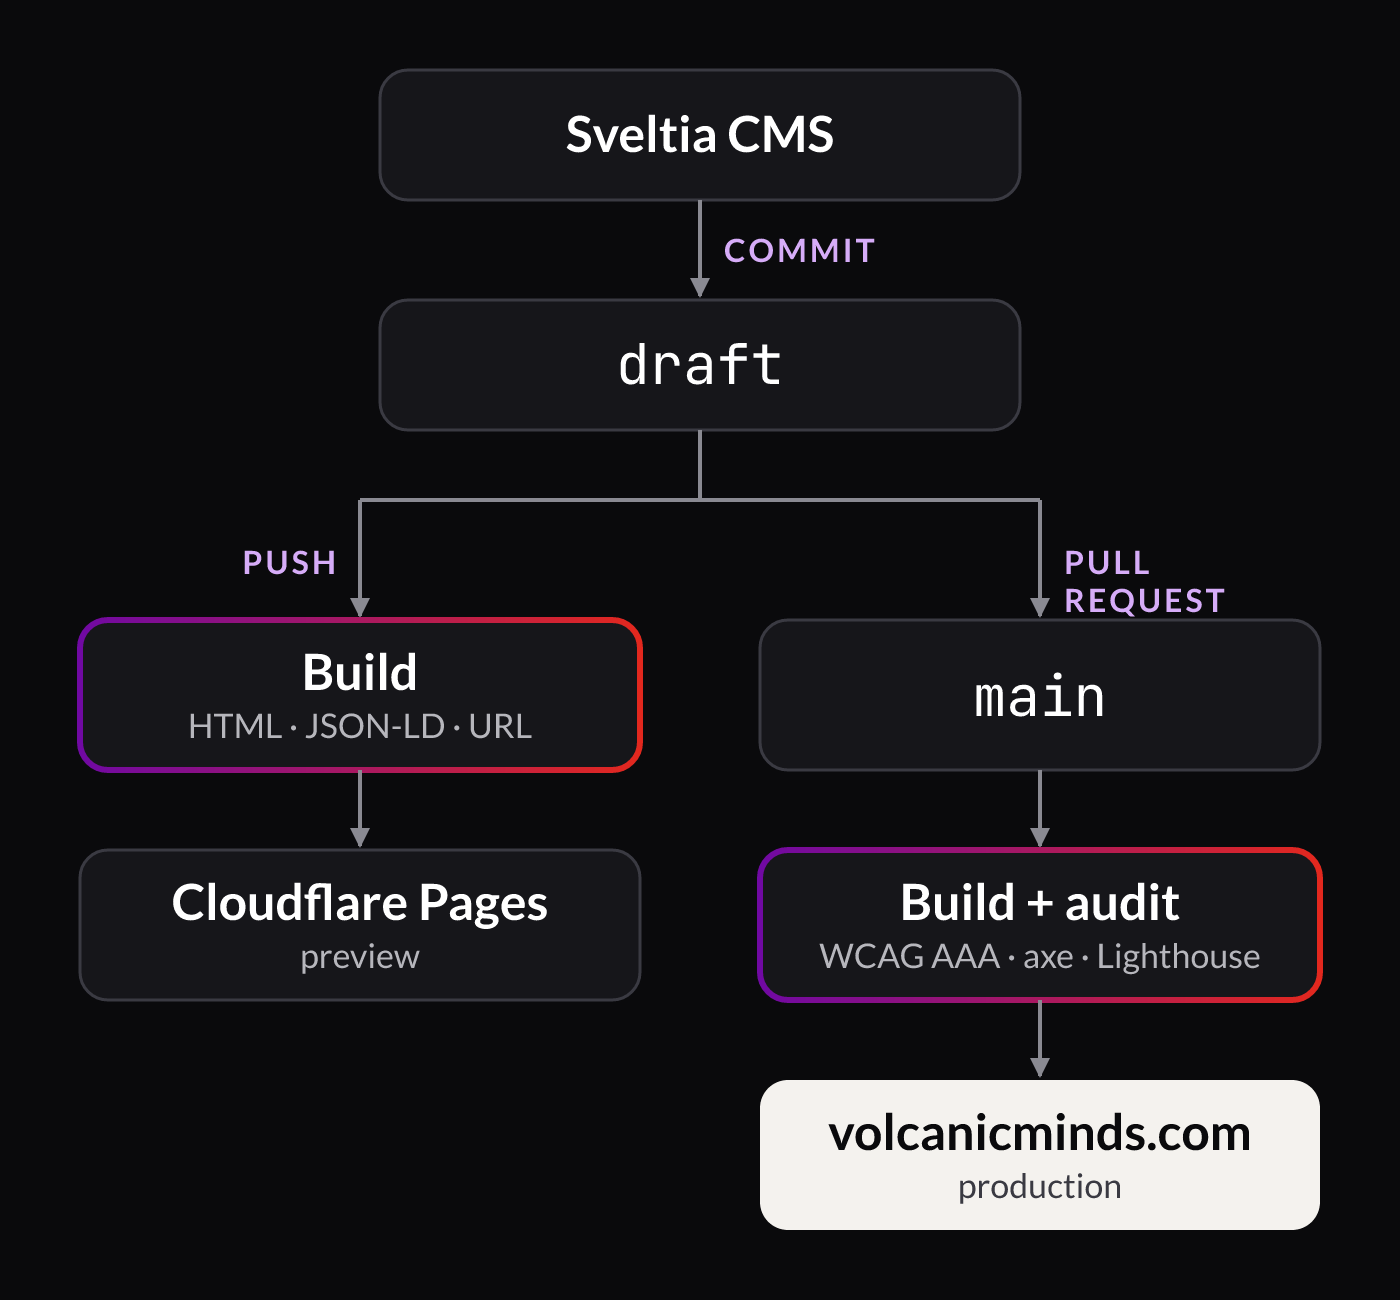
Il sito è costruito con Astro: durante la build ogni pagina diventa un file HTML, l'italiano alla radice e l'inglese sotto /en, e Cloudflare Pages serve quei file. In produzione non c'è un server applicativo e non c'è un database. Una piccola funzione sul bordo della rete fa solo le tre cose che un file non sa fare: la pagina 404 nella lingua giusta, la versione Markdown di una pagina a chi la chiede e l'intestazione che la annuncia. Non riscrive le pagine, non usa cookie e non conserva stato.
La conseguenza è che tu, Googlebot e un agente AI ricevete lo stesso HTML. Non ci sono script di terzi: la Content Security Policy accetta solo quelli del nostro dominio, e da lì arrivano anche le statistiche di Plausible, che non usa cookie.
Chi aggiorna i contenuti, se non c'è un database?
Ogni pagina, articolo e case study è un file YAML nel repository, uno per lingua con lo stesso nome. Chi scrive non vede né file né git: usa Sveltia CMS, un CMS open source che scrive quei file al posto suo. Ogni salvataggio è un commit su un ramo di lavoro, da cui si ricostruisce un sito di anteprima, e apre una richiesta di revisione verso il sito pubblico.
Le pagine si compongono a blocchi, come le slice di Prismic che usavamo prima. La definizione dei blocchi è una sola, e da lì nascono sia lo schema che valida i contenuti durante la build sia i campi che il CMS mostra. Un contenuto che rompe una regola, per esempio un link verso una pagina che non esiste, ferma la build con il nome del file e del campo invece di andare online.
Come legge il sito un agente AI?
Un modello linguistico che deve rispondere su di noi non ha bisogno del menu, delle animazioni o del piè di pagina. Per lui il sito ha quattro livelli, e ognuno ha un controllo che fallisce se una pagina ne resta fuori.
Il primo è il gemello Markdown. Ogni indirizzo indicizzabile ha una versione in Markdown allo stesso indirizzo con l'estensione .md, senza navigazione né markup. La stessa versione arriva all'indirizzo originale a chi la chiede con l'intestazione Accept, e ogni risposta HTML la annuncia con un'intestazione Link. Per esempio, la pagina degli strumenti per gli agenti:
$ curl -sH 'Accept: text/markdown' https://volcanicminds.com/webmcp | head -12---title: "WebMCP · Volcanic Minds"description: "Gli strumenti WebMCP di volcanicminds.com: otto in sola lettura e il modulo di contatto, cosa restituiscono, quali garanzie hanno e come provarli in Chrome."url: "https://volcanicminds.com/webmcp"lang: "it"type: "first_level_page"updated: "2026-10-06"alternate: "https://volcanicminds.com/en/webmcp"summary: "Il sito offre agli agenti AI otto strumenti in sola lettura e un modulo di contatto attraverso WebMCP, un'interfaccia del browser ancora in bozza. Qui trovi cosa fanno, con quali garanzie e come provarli."---# Gli strumenti per gli agentiIl secondo è llms.txt, l'indice pensato per i modelli linguistici, con accanto llms-full.txt e il testo integrale, uno per lingua. Il controllo parte dalla sitemap, l'elenco di ciò che esiste, e per ogni indirizzo verifica che il gemello ci sia e compaia in entrambi i file.
Il terzo sono i dati strutturati: ogni pagina ha un solo grafo JSON-LD, con i nodi legati da identificativi stabili. L'azienda è un nodo unico, completo sulle due home e su Chi siamo e citato per riferimento altrove, così chi unisce i grafi di pagine diverse non riceve mai due versioni della stessa azienda. Un nodo si scrive solo dove quello che descrive si vede: FAQPage solo dove le domande sono sulla pagina. Un estratto dall'articolo sul sito precedente:
{ "@type": "ProfessionalService", "@id": "https://volcanicminds.com/#identity", "name": "Volcanic Minds", "url": "https://volcanicminds.com"}{ "@type": "TechArticle", "@id": "https://volcanicminds.com/insights/making-of#article", "author": { "@id": "https://volcanicminds.com/#identity" }, "publisher": { "@id": "https://volcanicminds.com/#identity" }, "isPartOf": { "@id": "https://volcanicminds.com/insights/making-of#webpage" }}Il quarto è WebMCP, una bozza del Web Machine Learning Community Group del W3C con cui una pagina dichiara strumenti che un agente nel browser può chiamare. Ogni pagina del sito ne registra otto, tutti in sola lettura: una panoramica, la ricerca fra applicazioni, case study, articoli e domande frequenti, il dettaglio di un servizio, la definizione di un termine del glossario e i dati dell'azienda. L'unico strumento che scrive è il modulo di contatto. Nomi e descrizioni vivono in un solo punto del codice, da cui li leggono il browser e la pagina che li documenta.
Accessibilità e peso, misurati al pixel
L'obiettivo è il livello AAA delle WCAG 2.2, che il W3C stesso sconsiglia di pretendere da un intero sito, perché alcuni criteri non si possono soddisfare per certi contenuti. Per questo non lo diamo per raggiunto: la dichiarazione di accessibilità dice che il sito è conforme al livello AA e soddisfa 19 dei 22 criteri AAA che lo riguardano, e spiega i tre che mancano, tutti sul linguaggio: parole inusuali, abbreviazioni, livello di lettura.
Il resto lo misura una macchina, su ogni pagina e nelle due lingue, in un browser vero, nel tema chiaro e in quello scuro, a quattro larghezze e in più a 320 pixel. Il contrasto del testo deve arrivare a 7:1, anche sopra i gradienti. Ogni area cliccabile misura almeno 44 pixel per lato. Le righe del testo di lettura non superano 80 caratteri, contati uno per uno sulla pagina, con un'interlinea di almeno 1,5. La pagina non deve scorrere in orizzontale a nessuna larghezza, in nessun momento delle animazioni, e nessun testo si deve tagliare quando si forzano le spaziature del criterio 1.4.12. Un blocco che deborda o un'immagine disegnata più larga del suo file sono errori; una parola rimasta sola in fondo a un titolo viene segnalata. Poi passano le regole di axe-core per i livelli A, AA e AAA.
Senza JavaScript la pagina si legge intera: le animazioni di comparsa si attivano solo quando lo script c'è. Se il sistema chiede movimento ridotto le animazioni non partono, e dove qualcosa si muove c'è un comando per fermarlo.
Il peso ha soglie che fermano la build: 30 KB di HTML compresso per pagina, 15 KB di JavaScript nostro, nessun byte di JavaScript di terzi. L'unica eccezione è la pagina delle domande frequenti, con un tetto di 33 KB, perché togliere i suoi dati strutturati per rientrare costerebbe più del peso risparmiato. Lighthouse misura ogni modello di pagina su mobile e su desktop con 1 come soglia sulle quattro categorie; l'unica eccezione, scritta nel codice con il suo motivo, è il minimo di 0,95 per le prestazioni su mobile. Nella categoria Agentic Browsing, ancora sperimentale, nessun audit può fallire.
Come si evita che una modifica peggiori il sito?
Con una pipeline che legge il sito costruito, non solo il codice. Oltre ai controlli già visti passano il Nu HTML Checker del W3C, con zero errori come soglia, e le nostre regole sull'HTML: un solo h1, titoli senza salti di livello, ogni navigazione con il suo nome.
Un controllo a parte rompe di proposito ciascuna di queste protezioni, su una copia della build, e fallisce se la protezione non se ne accorge. Un controllo che nessuno ha mai visto fallire è un controllo che nessuno sa se funziona.
Che cosa abbiamo lasciato fuori?
Cookie e banner, script e iframe di terzi, Google Analytics, un server che costruisce le pagine a ogni richiesta, un database da aggiornare e da proteggere. Il prezzo esiste: l'anteprima arriva dopo un paio di minuti e una pagina cambia solo quando cambia un file. Per un sito fatto di contenuti editoriali, uguali per chiunque li legga, conviene pagarlo.
Fonti e approfondimenti
- Astro, il framework del sitoastro.build, consultato il 16 ottobre 2026
- Sveltia CMSgithub.com, consultato il 16 ottobre 2026
- The /llms.txt filellmstxt.org, consultato il 16 ottobre 2026
- WebMCP, bozza del Web Machine Learning Community Groupwebmachinelearning.github.io, consultato il 16 ottobre 2026
- Web Content Accessibility Guidelines (WCAG) 2.2w3.org, consultato il 16 ottobre 2026
- Nu HTML Checkervalidator.w3.org, consultato il 16 ottobre 2026
Il codice di questo sito è pubblico?
No, il codice di questo sito non è pubblico. Altri progetti open source di Volcanic Minds sono invece sul nostro profilo GitHub, dal backend agli esempi di agenti AI.
Perché i contenuti in Git invece di un CMS headless come prima?
Perché contenuti e codice stanno nella stessa storia. Ogni modifica è un commit che si può rileggere e annullare, e un contenuto sbagliato ferma la build invece di arrivare online.
Un sito statico va bene per ogni progetto?
No. Va bene quando i contenuti cambiano con un lavoro editoriale e sono uguali per tutti. Un'area riservata, un carrello o pagine diverse per ogni utente chiedono un server e un database, e in quel caso li progettiamo. Lo stack si sceglie partendo dal problema.
Devi portare questa tecnica in produzione?
Se il tuo team deve farla funzionare su un progetto vero, con vincoli di sicurezza e di costo, possiamo affiancarlo o costruirla insieme.
Altri articoli sullo stesso tema.
Web Bot Auth: visitatori senza occhi
Gli agenti AI leggono il tuo sito e convertono meglio dell'organico, ma non compaiono negli analytics. Come misurarli e verificarli con Web Bot Auth.
Leggi
Generative UI: per umani e macchine
Il tuo gestionale serve persone e agenti AI. Con la Generative UI l'interfaccia si compone sul contesto, con un accesso per gli agenti e un fallback manuale.
Leggi
L'accessibilità digitale non è un bollino
Affidarsi agli overlay di accessibilità non garantisce la conformità WCAG AA ed espone l'azienda a rischi legali e commerciali. Scopri come evitarli.
Leggi